cat ~/notes/ulimit-docker-janus.md
ulimit di docker: waktu sfu janus kehabisan file descriptor
[en]ulimit di docker: waktu sfu janus kehabisan file descriptor
Setiap container itu kadang kita bikin dengan resource dan setting-an seadanya… yg default. Intinya yowes, yang penting jalan.
Limit RAM, CPU, ga terlalu kita pikirin, karena ngerasa resource VM-nya udah gede, udah cukup.
Tapi seiring waktu, ada aja masalah yg muncul… kadang di-trigger sesuatu dari luar, kayak traffic yg tiba-tiba gede.
Dan ya, ini gw ngalamin sendiri. Sampe lupa ada yg namanya ulimit… soalnya gw pake docker, dan dia ke-abstract, ga keliatan.
Dan semuanya berawal dari sini.
Outgoing audio sama video call di janus tiba-tiba putus massal di pagi hari.
Dashboard API nunjukin traffic naik tiga kali lipat, tapi median durasi call turun drastis. Ternyata pemicunya bukan memory, CPU, atau network… tapi batas file descriptor bawaan docker yg ga pernah disetel.
client: “halo mas, ini kok gak bisa ngelakuin panggilan ya”
Gitu pesan yg masuk pagi itu. Bukan dari alert, bukan dari dashboard yg merah… dari client langsung.
Dan di situ gw baru sadar satu hal yg bikin ga enak: ga ada alert apa pun yg jaga service ini. Kalo dia down, ga ada yg teriak. Orang pertama yg tau ada yg rusak malah client.
Gw buka, dan emang bener… segelombang call putus di tengah obrolan, barengan, di pagi yg harusnya biasa aja.
Dashboard-nya saling bertolak belakang. Traffic API masuk naik hampir tiga kali lipat, tapi median durasi call turun setengahnya. Call makin banyak, masing-masing durasinya lebih pendek.
Bacaan pertama: lonjakan traffic. Jadi API-nya gw scale out. Tapi API ga pernah jadi masalah… 5xx datar di 0.0%, p99 sekitar 75 ms, tiap response 200 bersih. Traffic-nya beneran, tapi itu gejala dari sesuatu yg lebih hulu.
Sebenarnya SFU tuh ngapain aja?
Sistemnya satu proses janus jalan sebagai SFU. Kenapa SFU, bukan mesh atau P2P, gw udah bahas di post janus sebelumnya. Semua call 1:1, tapi media-nya tetap lewat server… client kirim RTP ke janus, janus relay ke lawan. Tiap call direkam di server, dan client-nya auto-retry begitu call putus.
janus jalan sebagai container standalone dengan --network host, buat range port UDP gede yg dibutuhin RTP. Restart policy-nya unless-stopped, jadi kalo dia mati, docker langsung hidupin lagi.
Dua behavior ini yg penting nanti: client auto-retry (nyetup call baru) saat call putus, dan docker restart container saat prosesnya exit.
Step change, bukan tren gradual
Kalo call putus, jalur media yg mesti diliat, bukan API. Dan resource media semuanya aman: egress ~46 Mbps lawan plafon yg jauh lebih gede, janus ~80% dari satu core, memory sisa banyak, disk 35%. Ga ada yg ngejelasin call mati di tengah jalan.
Waktu datanya di-bucket per setengah jam, keliatan patahan yg jelas… call sehat rata-rata 4-5 menit, terus dalam satu bucket 30 menit durasi rata-ratanya langsung anjlok.
Kalau resource-nya abis pelan-pelan, di time series keliatan sebagai tren yg gradual. Ini engga… metriknya step change, loncat mendadak di satu titik waktu. Artinya ada event, bukan degradasi bertahap. Event-nya ada di log janus:
Initializing ICE stuff (Lite mode...)Baris itu muncul sekali, waktu janus start. Dia muncul tiap 90 detik.
janus ga lagi ngelayanin call. Dia restart, berulang-ulang. Dan tiap restart narik semua call yg lagi hidup ikut mati.
Kenapa janus mati terus
Kernel yg pegang penyebabnya:
traps: janus[...] trap int3 ... in libglib-2.0.so.0.7400.6int3 itu software breakpoint… SIGTRAP. glib nge-raise ini lewat g_error(), jalur fatal internalnya. Ada error di glib yg ga bisa dipulihin, sampai akhirnya narik seluruh proses ikut mati.
Log janus nyebut apa:
GLib-ERROR: Creating pipes for GWakeup: Too many open files
record.c ... fopen error: 24
errno 24 itu EMFILE, too many open files. janus bahkan ga bisa buka file recording. File descriptor-nya udah abis.
Dan itu dia… ulimit yg tadi gw lupain:
cat /proc/$(pgrep -x janus)/limits | grep 'open files'
# Max open files 1024 ...- Default linux jadul, kewaris ke container karena ga ada yg nyetel lain. Dan SFU WebRTC itu mesin file descriptor… tiap call buka socket UDP buat RTP sama RTCP, eventfd buat main loop glib, dan satu handle per recording. Beberapa ratus call barengan dan janus udah deket tembok.
OOMKilledfalsedari awal sampe akhir. Ga pernah soal memory. Ini soal file descriptor.
Storm-nya ngejelasin dirinya sendiri
Di sini dashboard yg tadi kontradiktif jadi masuk akal.
Tiap crash mutus semua sesi WebRTC yg aktif. Dan client-nya emang dirancang buat auto-retry: begitu sesinya putus, dia langsung nyoba nyetup call baru dari nol… signaling ulang, join room di SFU lagi, handshake ICE/DTLS lagi. Gelombang re-initiate itu nabrak janus yg baru naik lagi menuju limit FD yg sama, jadi dia tembus lagi dan crash lagi, kira-kira tiap 90 detik.
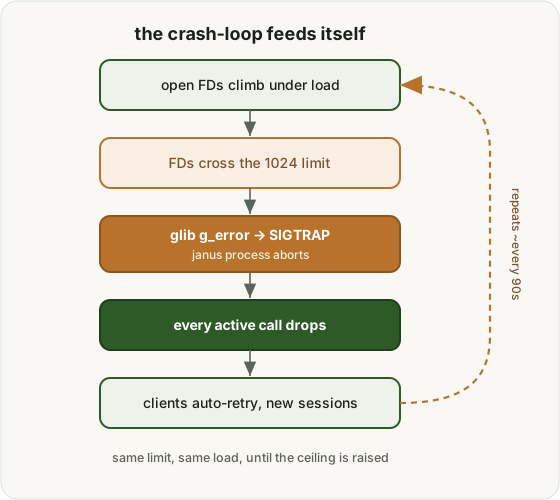
Database-nya ngasih tau bentuknya. Dibandingin sama pagi-pagi biasa, jumlah caller unik nyaris ga gerak… tapi rata-rata call per caller kira-kira dobel.
Bukan user baru berdatangan. Caller yg sama, auto-retry call terus ke dalam crash-loop. Itu yg bikin traffic API naik tajam… tiap retry satu siklus signaling call yg lengkap, dari setup sampai teardown.
Tiap angka yg bikin panik pagi itu balik ke satu hal: satu proses kehabisan file descriptor.
Naikin plafonnya
Fix-nya satu flag di container:
docker run -d --name janus --network host --restart unless-stopped \
  --ulimit nofile=1048576:1048576 \
  janus-image
nofile itu limit open file, soft sama hard. Flag runtime… ga perlu rebuild image, ga ada yg lain di-redeploy. ulimit ga bisa diubah di proses yg lagi jalan, jadi janus mesti di-recreate biar kebaca. Itu mutus call yg lagi jalan sekali, trade yg worth dibanding crash tiap 90 detik.
Terus verifikasi ke kegagalan awal, bukan ke deploy:
cat /proc/$(pgrep -x janus)/limits | grep 'open files'
# Max open files   1048576 ...
docker inspect janus --format '{{.RestartCount}}'
# 0, dan tetap 0
Nol restart beberapa jam berikutnya, ga ada int3 baru di kernel log, backlog recording drain, durasi call balik normal.
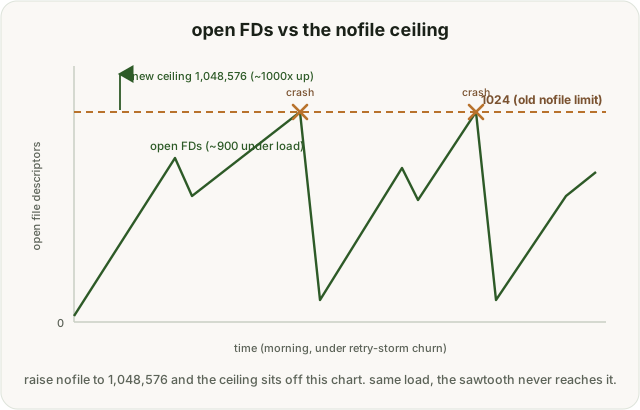
Angka yg paling meyakinkan: jumlah descriptor kebuka pas beban sore, sekitar 900. Dengan limit lama 1024, janus hidup cuma selisih seratusan descriptor dari ambang batas. Itu kenapa dia cuma rusak pas rame, dan langsung tumbang mendadak begitu plafonnya tembus.
Overhead ulimit dan tempat konfigurasinya disimpan
Ga ada yg kerasa. nofile itu plafon, bukan reservasi… janus cuma buka descriptor sebanyak yg dia butuh. Naikin dia ga ngalokasiin apa-apa. Cuma mindahin tembok jauh-jauh biar beban normal ga pernah nyampe.
Tapi limit-nya nempel di container, bukan image. Restart biasa bakal tetap nyimpen limit itu. Kalo container di-recreate dari command lama tanpa flag tadi, plafonnya diam-diam balik ke 1024. Jadi flag-nya mesti nempel di script deployment yg beneran nyalain prosesnya, bukan cuma disetel manual di satu container.
Dan worth dipantau… biar lain kali yg teriak duluan bukan client. Buat nangkep kalo kambuh, gw ngitung banner startup langsung dari log, bukan metrik restart container:
sum(count_over_time({container="janus"} |~ "Initializing ICE stuff" [10m])) > 3Satu-dua start dalam sepuluh menit itu deploy. Lebih dari tiga itu crash-loop. Baris itu bakal nyala dalam sepuluh menit dari crash pertama, ga kayak dua jam yg beneran kejadian.
Limit-nya ada di situ dari awal. Dia ga berubah… beban-nya yg berubah. Itu masalah klasik default yg ga pernah disetel: dia ga keliatan salah, sampai suatu hari ada traffic yg akhirnya nyentuh batas itu.
Kesimpulannya sederhana: ulimit (terutama nofile) itu batas di level OS yg sering kelewat waktu kita cuma fokus mantau CPU sama RAM. Begitu aplikasi lu mulai banyak buka socket UDP/TCP, file handle, atau event loop, plafon default 1024 di Linux bakal jadi tembok pertama yg bikin proses crash mendadak tanpa sempat ngeluarin error OOM.
Kalo lu ngejalanin service dengan koneksi concurrent tinggi di dalam docker, jangan percaya sama setting-an default. Selalu cek limit proses yg lagi hidup lewat /proc/<pid>/limits dan set --ulimit nofile secara eksplisit dari awal.
Kalau lu suka cerita default docker yg ga keliatan sampe kena beban, ada juga cerita /dev/shm postgres yg kekecilan di swarm.